有一类计算任务,它的价值随时间衰减。
天气预报就是。同一个结果,提前 24 小时给出来,是防灾部署的依据;提前 2 小时给出来,只能算参考;等灾害发生了再算完,一文不值。
这就是气象数值预报的苛刻之处:它不只要求算得对,还要求算得快——而且"快"是硬指标,必须在天气发生之前算完。
这个行业对算力的渴望,从来不是"想要更多",而是"必须更多"。
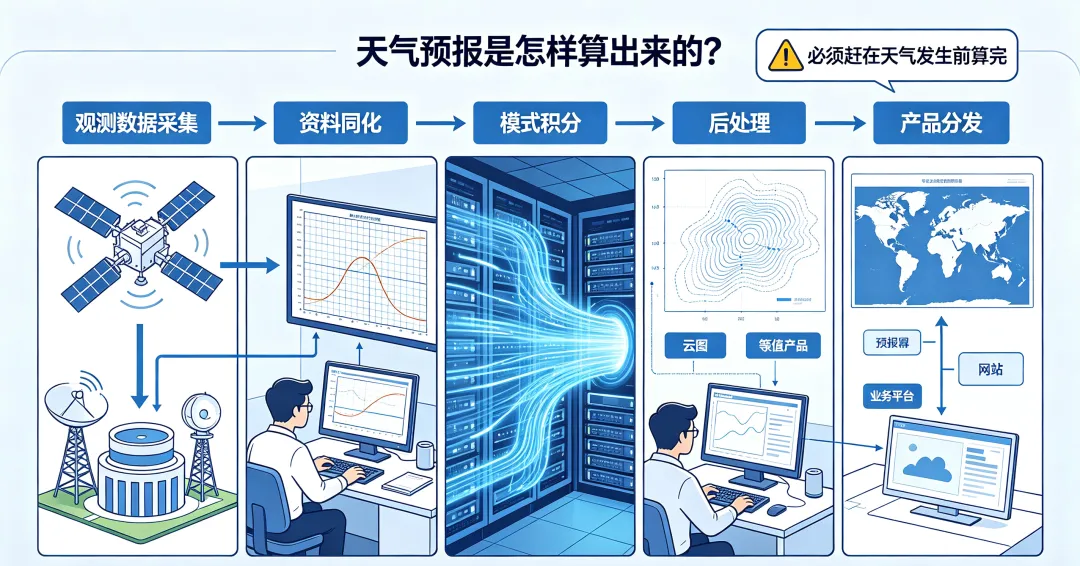
而一次预报要跑完五个环节:观测数据采集 → 资料同化 → 模式积分 → 后处理 → 产品分发。后面讲的每一个痛点,都能对应到其中的某一步。
这个行业正在发生四件事
第一件:分辨率一格一格往上走。
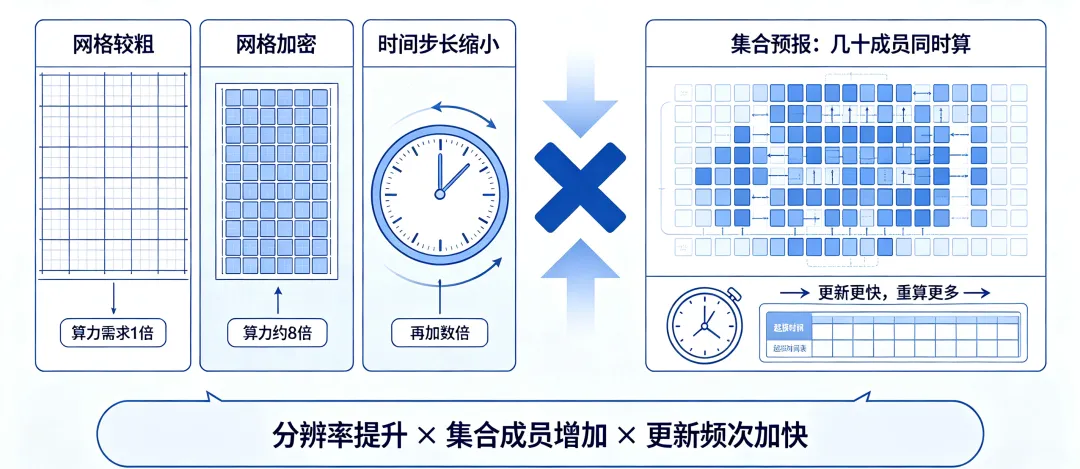
全球模式的网格间距从几十公里细化到十公里级,区域模式已经进入公里级。听起来只是数字变化,但网格加密一倍,三维网格单元数约增八倍;同时受数值稳定性条件约束,时间步长还要同比例缩小。两笔账叠起来,算力需求涨的是十几倍,不是一倍。
第二件:单一预报不够用了。
大气是混沌系统,预报本身带不确定性。过去给一个确定结果,现在要给概率——同一个初始场加微小扰动,跑几十个成员,用成员之间的离散度来回答"这场雨到底会不会下"。算力需求再乘以成员数。
第三件:更新频率在加快。
从每天两次起报,到逐小时滚动更新,再到针对强对流天气的快速更新循环。每一次更新,都是一次完整重算。
第四件:国产模式开始挑大梁。
GRAPES 等国产数值预报系统已进入业务化运行,覆盖全球、区域、台风、环境等多个分支。自主可控这条路走通了,但算力这一关躲不过去。
把四件事叠在一起看,结论很直接:算力需求是乘出来的,不是加出来的。
于是集群卡在六个地方
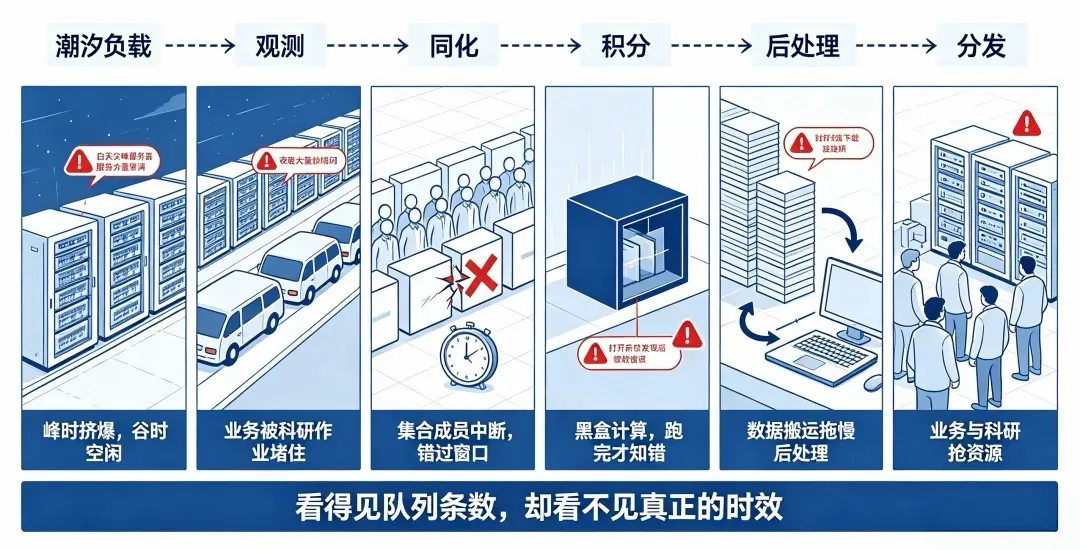
这六个痛点分别卡在计算流程的不同环节——有的是贯穿全程的,有的只卡在某一步。
痛点一:负载是潮汐式的,集群一会儿撑死,一会儿饿死
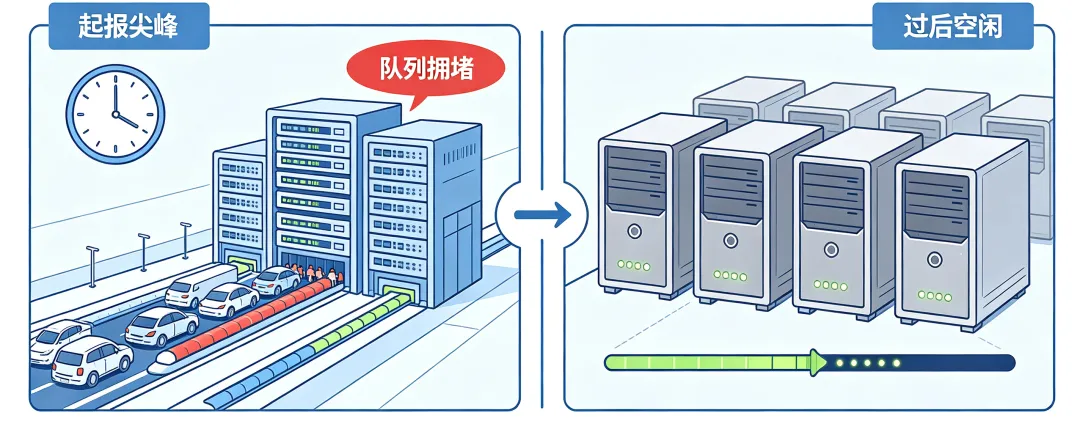
气象业务有固定起报时次。到了那个钟点,全球模式、区域模式、集合预报的几十个成员、后处理任务一起涌进来,集群瞬时被打满,全部开始排队。而过了这个时段,任务陆续跑完,大量节点空转。
问题在于:需求是脉冲式的,集群却是按峰值配的。为了扛住那个尖峰,必须按峰值买机器;尖峰之外的时间,这些机器就在闲置。这是气象 HPC 最本质的矛盾——不是算力总量不够,是算力的时间分布对不上需求的时间分布。
痛点二:时效是硬约束,调度却是软的
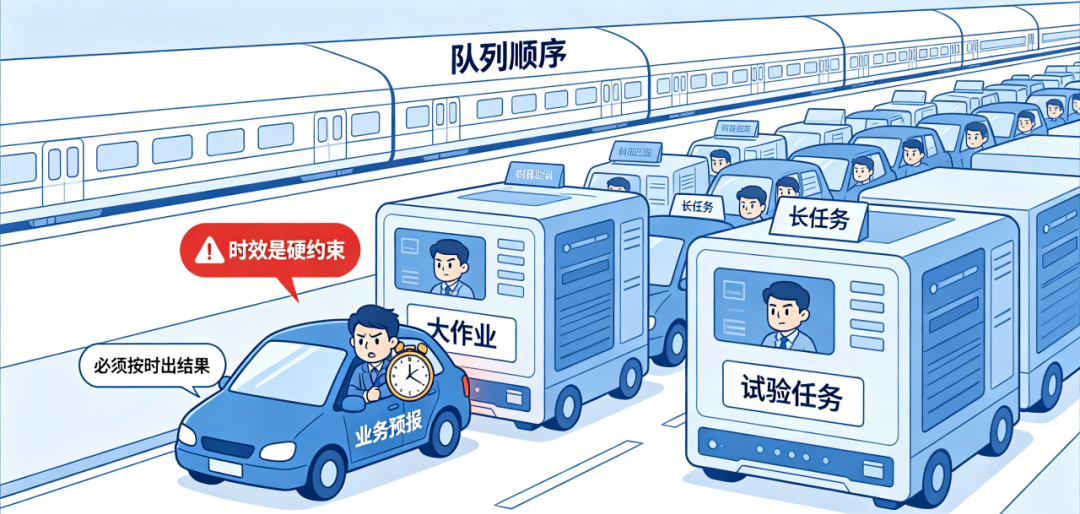
预报必须在某个时刻前出来,晚一分钟价值就折一分。但作业提交上去之后,能不能及时拿到节点,取决于队列前面排了多少活。一个科研试验的大作业正好堵在前面,业务预报就得等。时效这件事,在气象领域不是"体验问题",是业务问题。
痛点二:排得上队,还要跑得快
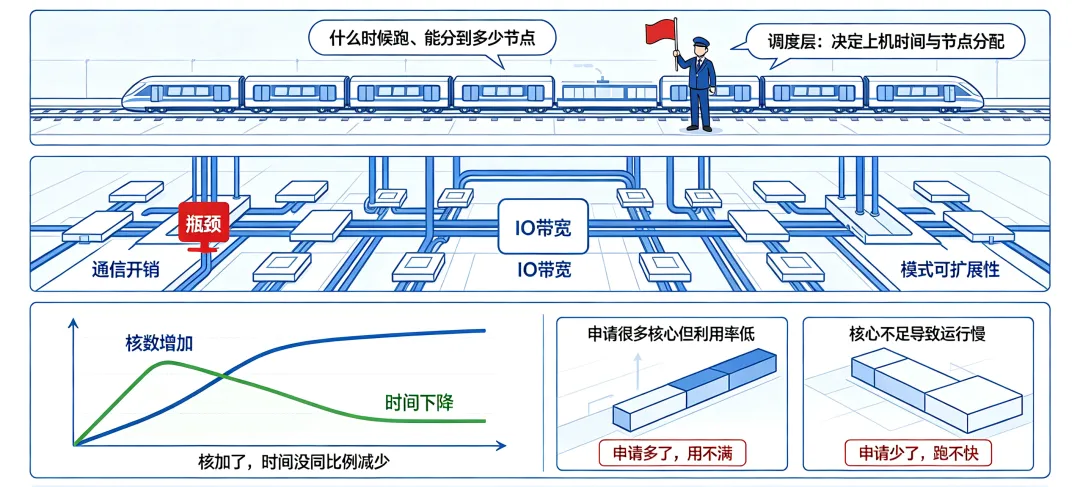
调度管的是"什么时候跑、能分到多少节点"——这一层调度能做得很细,作业什么时候上机,调度说了算。
但作业上机之后跑多久,取决于它自身的并行效率。受通信开销、IO 带宽和模式可扩展性的限制,核数加上去,时间未必同比例减下来;申请量与实际用量不匹配也是常见情况——核申请多了,节点占着却用不满;申请少了,又跑不快。
难点在于这一层往往看不见:作业跑完了、结果也没错,看上去一切正常。
痛点三:集合预报最怕中断
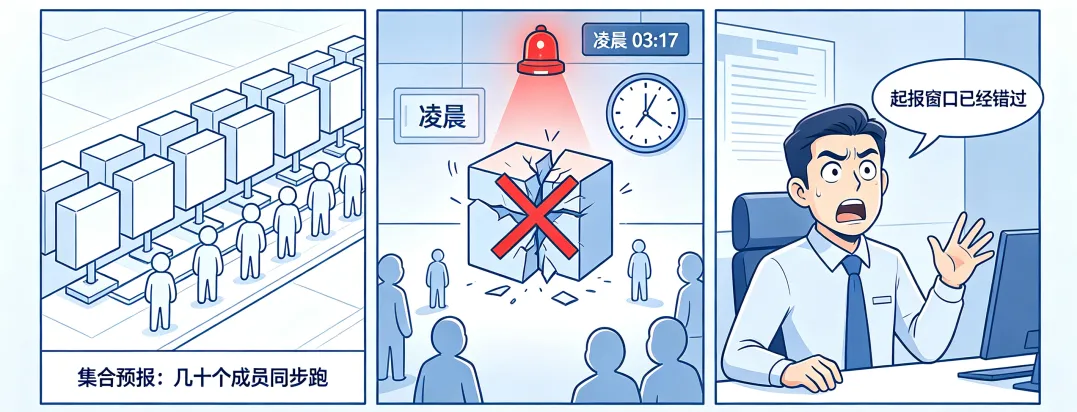
集合预报跑几十个成员,本来就是一个整体。某个成员中途失败,整个集合的可信度就打折扣。更麻烦的是发现得晚——凌晨挂掉,早上才知道,一次起报窗口就这么错过。而现阶段的处理方式往往还是人工:靠人发现失败、靠人重新提交、靠人把上一次的重启文件接回去。这是气象 HPC 特有的痛:别的行业错过一次计算可以重来,气象错过就是错过。
痛点四:算得对不对,跑完才知道
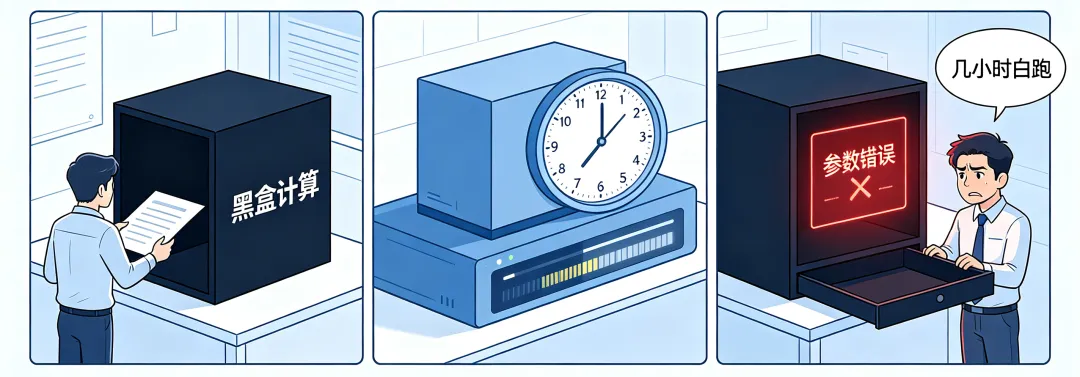
模式起转之后,参数配错、边界条件取错、物理方案选错,这些错误往往要跑到中途甚至跑完才暴露出来。跑了几小时才发现参数有误,等于整轮报废——而这几个小时,恰恰是时效最紧张的几个小时。
痛点五:结果是给业务系统用的
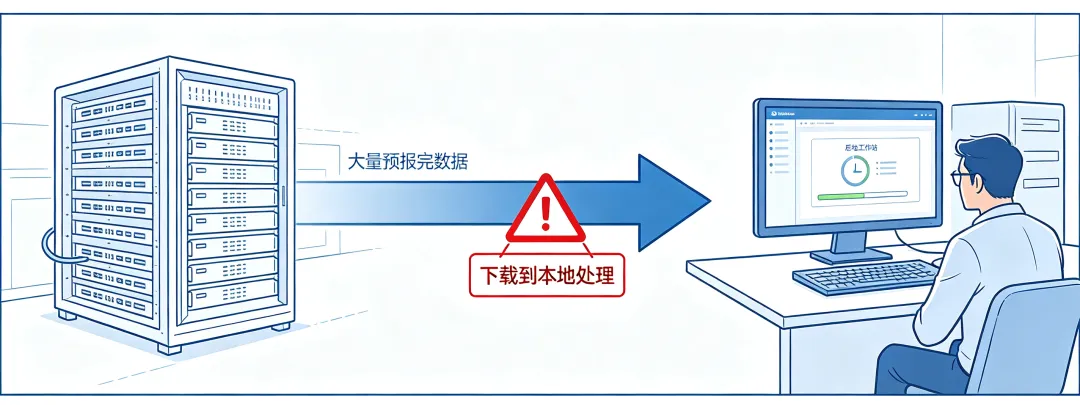
预报产品不是拿来自己看的,要出图、要分发、要进业务平台。模式算完只是半步,前后处理那半步同样卡时效。如果这一步要靠"下载到本地工作站处理",那么整个链条的时效就断在了最后一环。
痛点六:业务运行和科研试验在抢同一批机器
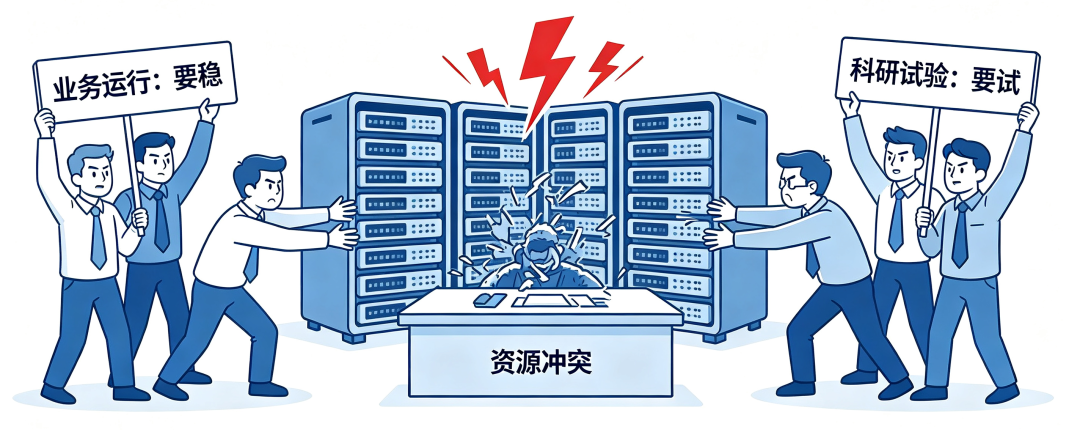
业务要稳,科研要试。两拨人的需求方向相反,却共用一套集群。科研作业把资源占满,业务运行就受影响;反过来,业务优先级一提,科研又排不上队。两边都不满意,而集群只有一套。
Unify怎么接这六刀
接痛点一:把峰值预留下来,把空档填起来
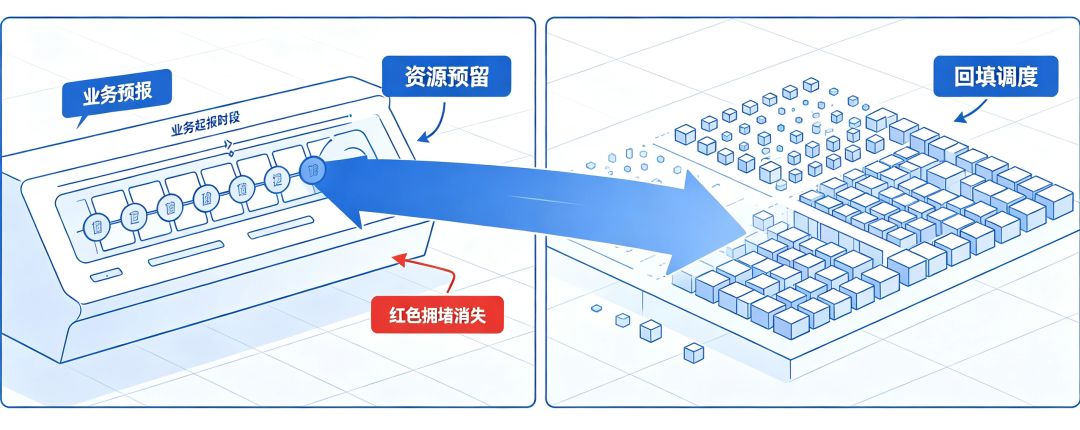
平台提供资源预留能力——在起报时次之前,把节点预先锁定给业务运行,到点即用,不必和队列里的其他作业争抢。
非起报时段,用回填策略把中小规模作业塞进大作业之间的空档,让闲置节点不再闲置。
一预留、一回填,集群就从"峰时撑死、谷时饿死"变成被摊平使用。不新增一台机器,可用的算力却变多了。
接痛点二:调度把资源给准,分析把效率看清
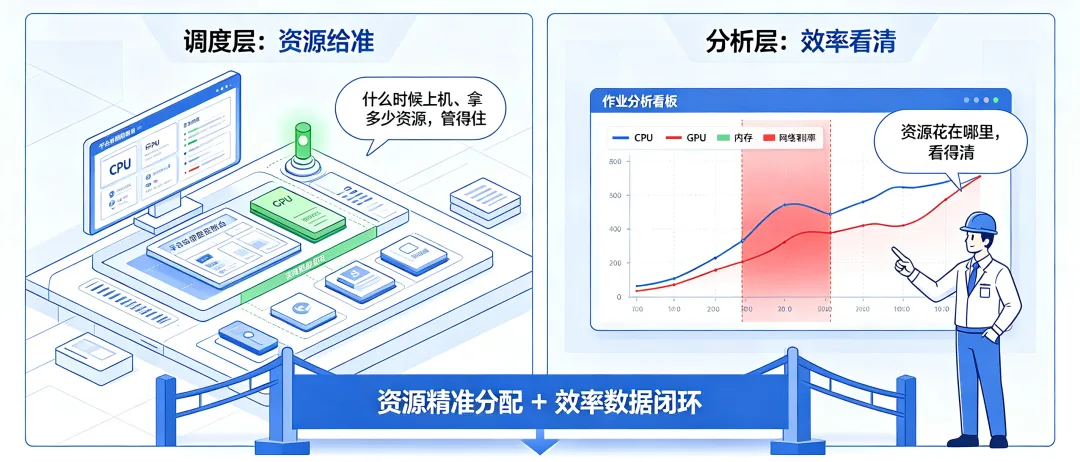
调度这一层,平台提供细粒度的资源控制——精细化管理 CPU、GPU、内存等硬件资源分配,支持任务隔离与实时监控。作业什么时候上机、能拿到多少资源,这一层管得住。
效率这一层,则由作业分析回答:提供 CPU、GPU、内存、网络等资源利用率信息,为作业优化提供数据支撑。
接痛点三:让它被更快发现,让重新提交不再依赖个人经验
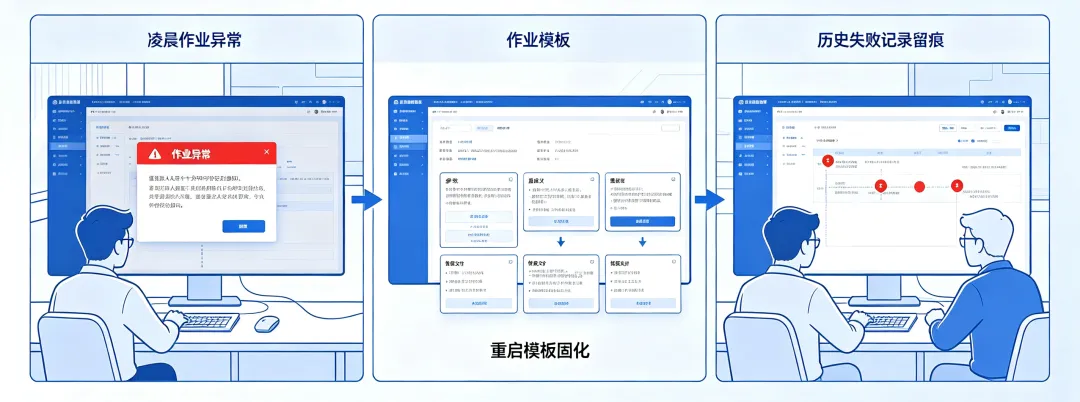
平台在这个过程中做三件事:
发现——节点故障、作业异常即时告警到统一门户。凌晨挂掉的任务,值班人员十分钟内就能看到,不必等天亮后翻日志。
接手——重启所需的参数(从哪份文件恢复、恢复到哪一步)固化成作业模板的一部分,运维按模板重新提交即可,不必翻文档、回忆当初的配置。
看清——作业的历史状态、失败的节点、失败时的资源情况都在平台上留痕,反复出问题的节点能被识别出来,而不是每次都当成偶然。
迁移仍要人工做,但单次成本从半小时以上降到几分钟,而且不依赖某一个人的经验。
接痛点四:把黑箱打开
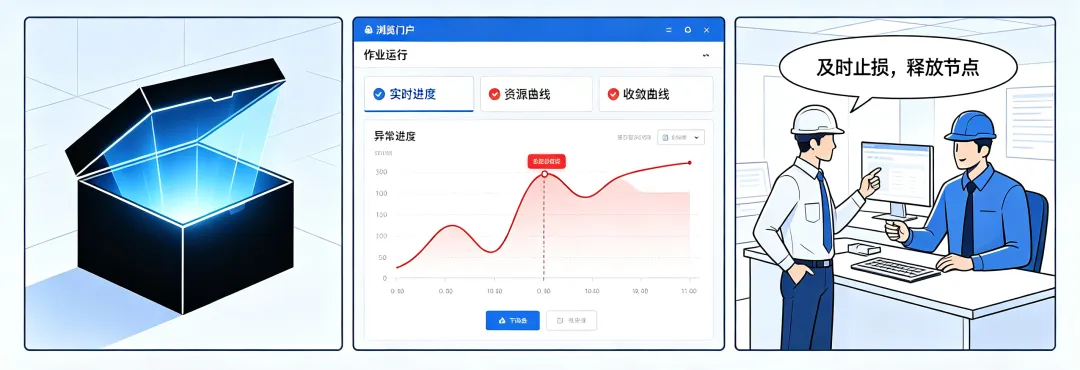
平台提供作业可视化,模式运行过程中的收敛情况、资源占用、进度都能实时看到。
参数配错、曲线发散,可以当场发现、当场停掉,把节点让给队列下游的作业。
过去工程师只有两种状态:等到结果,或者等到失败。现在多了第三种:正在跑,而且看得出跑得对不对。
接痛点五:前后处理不下机
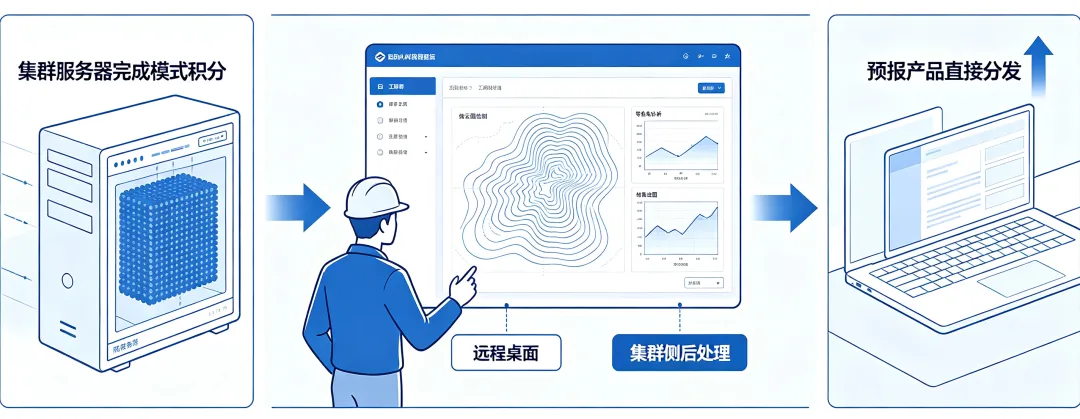
平台内置图形化远程桌面,工程师在浏览器或客户端里直接打开运行在集群上的图形应用。出图、后处理、结果查看全部在集群一侧完成,结果数据不必下载到本地。
省下来的不只是传输时间,还有"数据搬运过程中出岔子"的概率。预报产品从算出到可用,中间少了一道坎。
接痛点六:把业务和科研分域
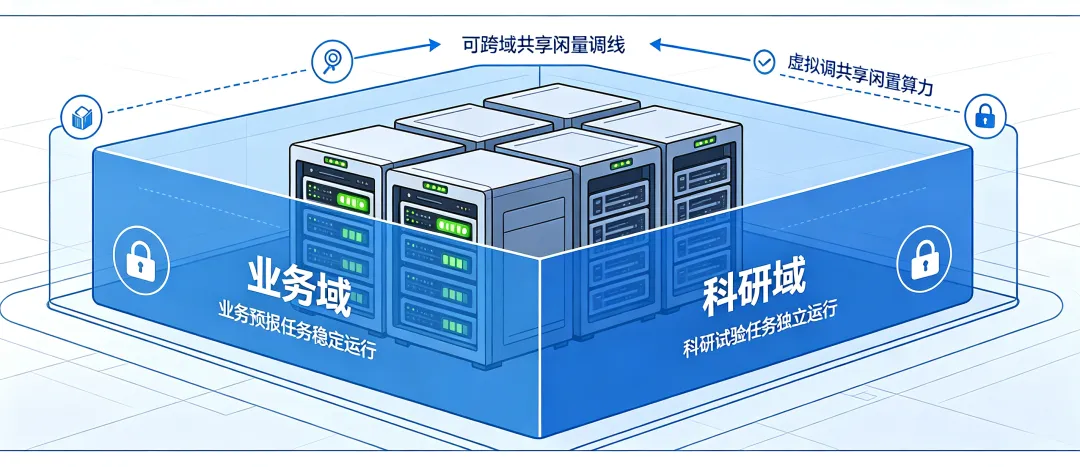
平台按"用户—项目组—集群—资源组—节点"的多级模型组织资源,不同项目组有独立空间,资源与数据互不干扰。
业务运行与科研试验可以在同一套集群上分域共存,互不打架;也可以在资源紧张时跨集群共享、借调其他集群的闲置算力。一套平台,两条互不干扰的跑道。
还有一件事:让集群自己说话
前面六刀都是人想出来的。但成百上千个作业、几千个核,靠人盯是盯不过来的。
平台的应用分析系统会持续算三件事:
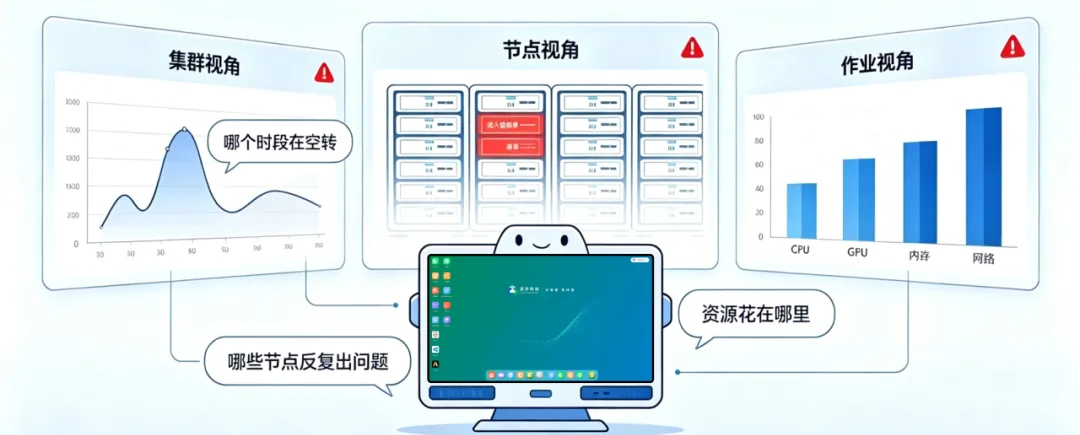
集群视角——整体利用率曲线的波峰波谷在哪,哪个时段在空转。这让"下一个起报周期该预留多少节点"从拍脑袋变成看数据。
节点视角——哪些节点反复出问题。一个节点在一个月内多次触发作业失败,它就该进检修名单,而不是继续留在池子里拖累别人。
作业视角——提供 CPU、GPU、内存、网络等资源利用率信息,为作业优化提供数据支撑。
把数据摊开,浪费才无处藏身。
气象数值预报是 HPC 最古老的战场之一,也是最诚实的战场——它不看你买了多少机器,只看你能不能在天气到来之前把结果交出来。
而决定这一点的,从来不只是机器的峰值性能。
是队列怎么分层、峰值怎么预留、断层怎么接上、黑箱怎么打开、结果怎么交付、业务和科研怎么共存。
这六件事,没有一件需要新增硬件。
这也是润宇科技 Unify 融合计算平台在做的事:把分散的算力变成随时可用的算力,把 HPC 的每一个环节,从"靠人扛"变成"靠系统跑"。
关于润宇科技
润宇科技专注智能计算与人工智能技术研发,聚焦产业 AI 落地,致力于降低人工智能应用门槛,把技术能力转化为稳定可运营的产业价值,助力各行业智能化转型升级。
预约演示 · 申请PoC · 获取方案
访问官网了解更多
产品咨询
185 7673 1805
业务咨询
132 7033 1670
本文转载自润宇科技微信公众号。点击阅读公众号原文。