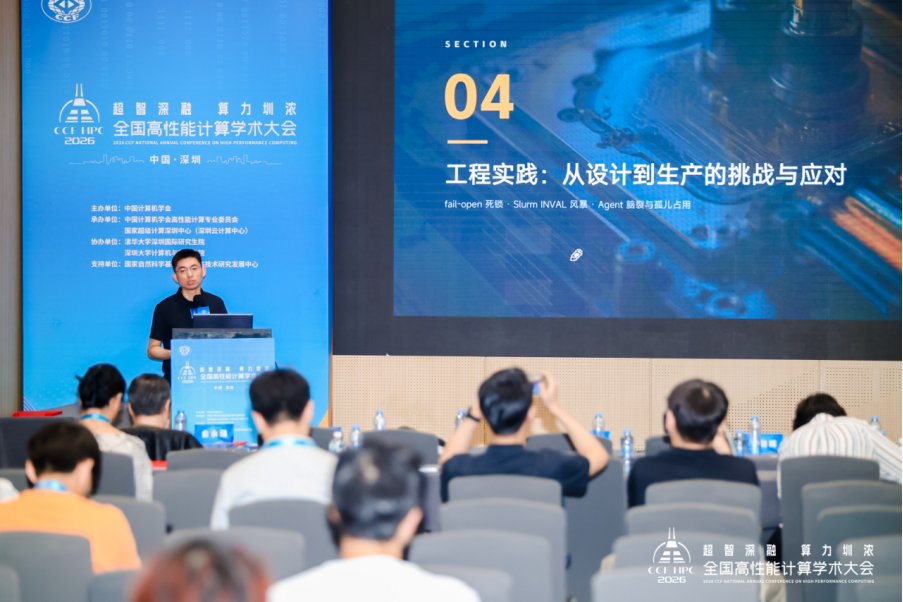
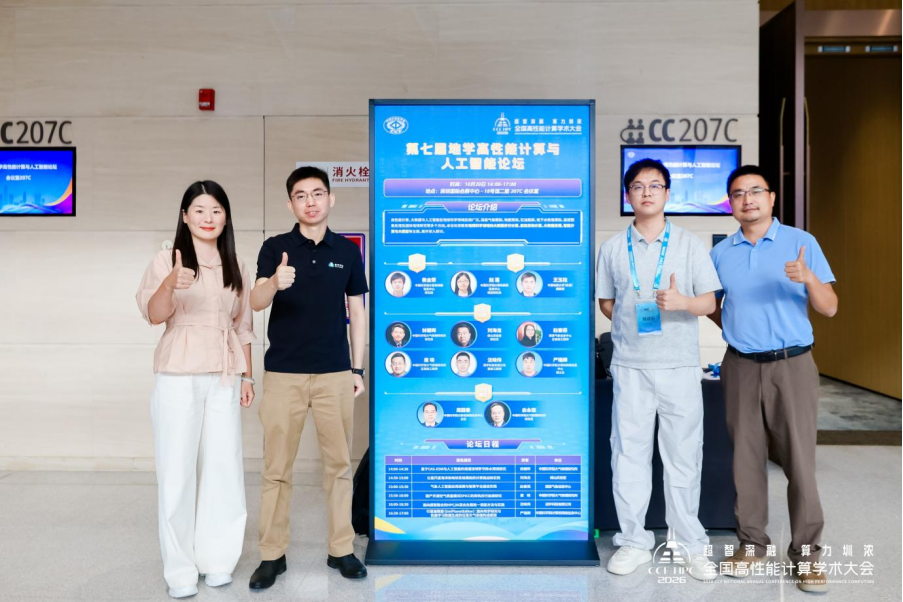
10月17日至20日,CCF全国高性能计算学术大会(HPC China 2026)在深圳举行。润宇科技有限公司首席工程师沈晓伟受邀出席第七届地学高性能计算与人工智能论坛,并发表主题为《面向超智融合的HPC/AI混合负载统一调度方法与实践》的演讲,分享公司在超算与智算融合调度领域的最新技术实践与产品成果。
随着AI大模型技术的爆发式发展,越来越多的科研机构和超算中心同时承载着传统高性能计算(如气象预报、工程仿真、地学模拟)和人工智能训练推理两类业务。但在实际建设中,这两类负载往往部署在相互独立的两套集群上——虽然物理服务器在同一间机房里,却因为两套管理系统各自为政,经常出现一边算不完排队、另一边资源空转的尴尬局面。沈晓伟在演讲中指出,这种“物理上共用、账面上分家”的现状,导致大量昂贵的算力资源被白白浪费,而要彻底解决这个问题,核心是要在两套系统之上建立一本双方都认可的“统一总账”。
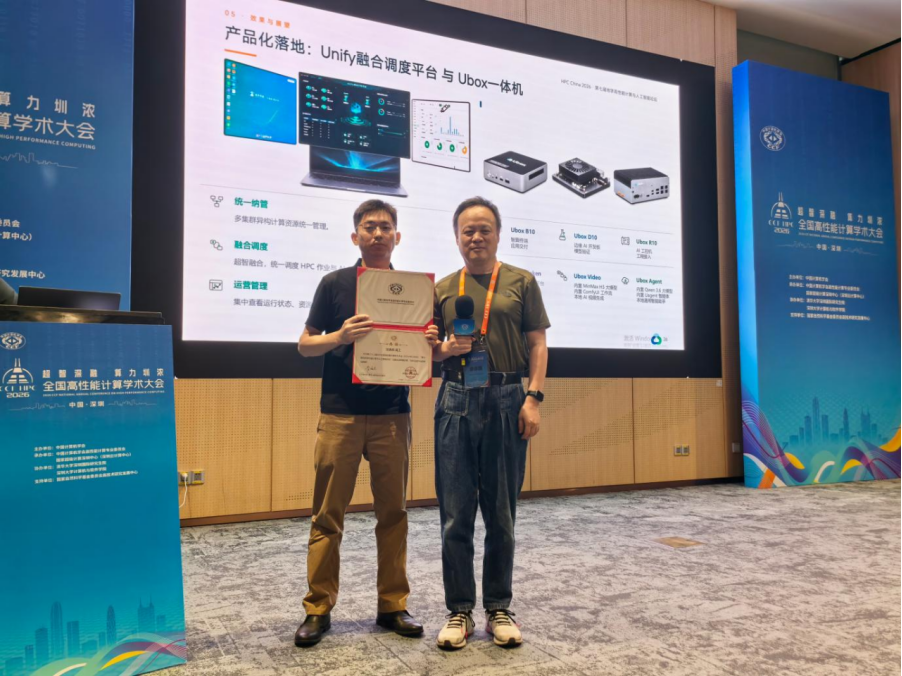
针对这一行业痛点,润宇科技自主研发了一套“资源统一账本”的融合调度方案。和业内常见的“推倒重来、替换原有调度系统”的路线不同,这套方案选择在完全保留原有Slurm和Kubernetes两套调度系统的前提下,于上层搭建一层统一的资源调度裁决中枢。这样一来,老用户不用改变使用习惯,多年积累的作业脚本、业务流程都能平滑继承;同时全局资源在调度层实现统一分配,从机制上杜绝了资源超分。方案还设计了专门的安全缓冲与故障自愈机制,即使遇到系统异常,也能确保业务不中断。
一项技术从实验室原型走到生产环境,要跨过无数工程门槛。演讲中,沈晓伟也毫无保留地分享了润宇科技团队在大规模落地过程中踩过的“坑”:包括系统降级时如何避免逻辑死锁、大规模节点变更时如何防止调度风暴等一系列硬核问题。他特别强调:“调度系统真正的考验从来不在风平浪静的时候,而在出故障的时候能不能自己站起来。一套敢给客户用的系统,容错和对账能力比理想状态下的性能参数重要得多。”
据了解,这套融合调度方案已经在万节点级集群规模下得到测试验证,实现了资源零超分配,调度响应延迟控制在毫秒级,经测试可帮助集群整体资源利用率最大可提升25%至35%。目前,这项核心技术已经正式产品化为润宇科技Unify融合计算平台,帮助各级超算中心、智算中心以最低的改造成本,快速实现超算与智算的融合升级。
关于润宇科技
润宇科技专注智能计算与人工智能技术研发,聚焦产业 AI 落地,致力于降低人工智能应用门槛,把技术能力转化为稳定可运营的产业价值,助力各行业智能化转型升级。
预约演示 · 申请PoC · 获取方案
访问官网了解更多
产品咨询
185 7673 1805
业务咨询
132 7033 1670
本文转载自润宇科技微信公众号。点击阅读公众号原文。